SurgLIME
Published:
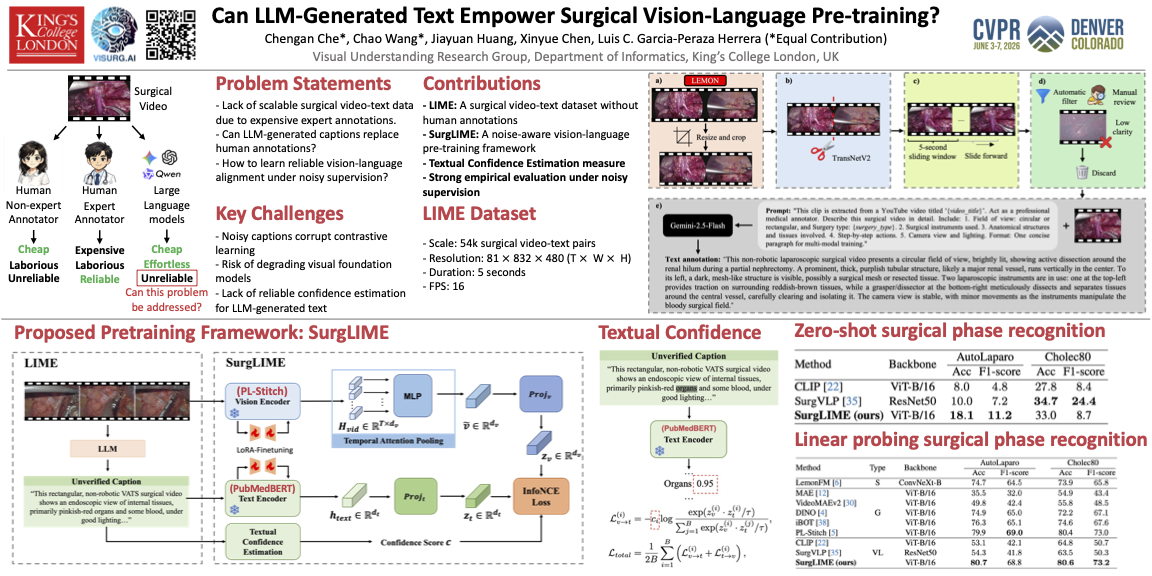
Can LLM-Generated Text Empower Surgical Vision-Language Pre-training?
Chengan Che, Chao Wang, Jiayuan Huang, Xinyue Chen, Luis C. Garcia-Peraza-Herrera
CVPR Workshops 2026, Oral Presentation
SurgLIME enables scalable surgical vision-language pre-training using LLM-generated textual descriptions. It combines parameter-efficient vision-language alignment with a confidence-aware mechanism that reduces the contribution of less reliable generated text during training.
* Equal contribution.


